2026 年 10 月 Hugging Face Papers Top20:自我改进、长期记忆与真实环境中的 Agent
作者:XD / 发表: 2026年11月4日 04:56 / 更新: 2026年11月4日 04:56 / 科研学习 / 阅读量:3
10 月的热门论文集中在几个具体问题上:失败经验能否变成训练信号,长任务如何保留有效进度,多模态推理怎样少做重复计算,以及机器人和搜索 Agent 离真实可用还有多远。下面按 Hugging Face 2026-10 月榜的点赞数,直接介绍 Top20。
数据快照:2026 年 11 月 4 日,北京时间。20 篇共 2664 票,平均 133.2 票;HF 元数据中 14 篇列出 GitHub,13 篇列出项目入口,包含 3 篇九月首发论文。同票按首发时间由近到远排列。点赞与 stars 均为本次 HF 快照记录的累计值,不是十月新增量;机构默认取 HF 字段,不等于完整作者单位,另行核实的单位会注明。以下实验结果均为作者报告,分析不代表独立复现。
Top20
1. Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
- 点赞:177
- HF 机构:jingdong;论文另列华南理工大学、清华大学、中国科学技术大学、鹏城实验室。
- 链接:HF · arXiv · 论文全文
- 开源情况:本次 HF 快照未列出 GitHub 或独立项目页。
中文摘要:LayerEditor 解决的是生成图片之后“还能不能接着改”的问题。常见图像编辑器输出一张合成图,文字、主体和背景已经混在一起;单独做图层分解,又不一定理解原来的编辑要求。它把指令编辑和图层生成合并:输入源图、修改要求与目标图层数量,同时输出编辑后的画布和按顺序排列的 RGBA 图层,让后续移动、替换或复用单个元素成为可能。
方法与结果:模型将整图、各层 RGB 和透明度统一放入 token 序列,通过专用 Alpha 解码器恢复不透明度。Compositional Edit-Prior Distillation 不仅约束直接生成的画布,也约束图层重新合成的结果,避免“整图看着对,拆开却不好用”。作者构建了 LayerEditor-100K 配对数据。在无需针对图像分解单独微调的实验中,Crello 测试集的合成图 SSIM 为 0.8761,高于 Qwen-Image-Layered 的 0.7963;去掉蒸馏后,多项编辑和图层指标下降。方法、实验与局限
怎么看:对海报、电商素材和设计工具,交付可复用图层比只交付一张漂亮图片更有价值。不过,RGBA 图层不等于完整设计源文件:论文明确说明文字仍是栅格图,不是可编辑字体或矢量对象;实验最多覆盖十层,透明边缘和细结构仍有瑕疵。实际评测应加入移动图层后的露底、重组后的边缘质量,以及连续多轮修改的稳定性。

图源:作者论文 Figure 2。左侧为联合图层建模,右侧为组合编辑先验蒸馏。
2. Self-Retrospection Distillation: Turning Post-hoc Experiences into Prior Foresight
- 点赞:161
- HF 机构:Salesforce AI Research;作者仓库还列出 UC San Diego、Texas A&M University、Stanford University。
- 链接:HF · arXiv · GitHub(13 stars)
中文摘要:强化学习经常把一段复杂经历压缩成最后的对错奖励。但同一组尝试全错或全对时,组内相对奖励就缺少区分度,轨迹中包含的错误原因和任务要求却仍有价值。SRD 提出“前瞻学习”:先用完成后的经历总结应当提前知道什么、避免什么,再把这种事后信息蒸馏到尚未交互的模型中,使失败经历也能改善行动之前的判断。
方法与结果:同一策略分别在有、无事后经历的条件下形成前瞻预测,并在自己的采样上对齐分布。该目标作为 RLVR 或自蒸馏的辅助项,不要求部署时额外生成一段前瞻文本。作者在十项工具推理和 Agent 任务上报告最高 24.2 个百分点的增益。更极端的 2B 实验里,98% 的采样组全部失败,相同 rollout 预算下,基线最终训练成功率为 0.0%,加入 SRD 后为 60.6%;注意,这是训练过程的成功率,不是十项测试的平均分。论文 v3,实验 RQ3
怎么看:它值得借鉴的地方是区分“结果没差别”和“经历没信息”。做工具调用、搜索或长流程训练时,错误日志里往往已经包含缺失条件和危险操作。但事后总结也可能给出错误归因,因此需要同时检查总结质量、额外训练开销和独立测试收益。不能仅凭训练成功率跃升,就推断模型已经获得稳定的跨任务预判能力。
3. Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
中文摘要:Kandinsky 6.0 Video 从单纯视频生成扩展到同步音视频生成,包含 3B 的 Lite 和 29B 的 Pro。两者支持文本或图像条件,生成带声音和口型同步的五秒片段,并通过内置超分辨率模型把输出提升到 1920×1080。它关注的不只是给画面配背景音乐,而是让语音、事件声音和视觉变化在时间及语义上对应。
方法与结果:核心 CrossDiT 使用视频、音频双流,通过双向交叉注意力交换信息。训练先继承已有视频能力、单独训练音频流,再使用配对音视频联合训练,之后依次进行监督微调、强化学习后训练与蒸馏。论文的人类并排评测显示,Pro 优于上一代,并在部分音视频维度上与所比较模型竞争,尤其强调语音质量。作者以 MIT 许可发布代码和模型,仓库提供部署入口。架构、训练及评测
怎么看:这是一条适合观察开源音视频系统如何逐层搭建的路线,双流交互和分阶段训练都有可迁移价值。需要分开看原生生成、超分辨率和加速版本:最终达到 Full-HD,不代表主干从头就以该分辨率生成;五秒样例也不能证明长片段一致性。部署评估还应把模型加载、音画联合采样和超分辨率耗时算在一起,而不是只比较某个阶段的速度。
4. PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
- 点赞:152
- 机构:HF 字段为空;论文首页列出 Peking University、JD.com。
- 链接:HF · arXiv · 论文全文
- 开源情况:本次 HF 快照未列出 GitHub 或项目页。
中文摘要:VLA 模型需要从图像和指令预测动作,却未必理解动作会怎样改变物体与场景。视频世界模型可以提供动态知识,但在每个控制周期生成未来视频会增加延迟。PDRVLA 的折中是学习轻量的物理动态表示:让模型在训练时吸收未来变化的信息,运行时只生成紧凑的 physical tokens,再用这些表示引导动作,而不在线生成视频。
方法与结果:Physical Dynamics Module 从视觉语言特征提取动态 token,通过预测未来 RGB、深度和光流特征训练,同时接受冻结视频世界模型的辅助监督。训练数据均来自公开来源,并经过人类动作到机器人动作的合成、子任务标注和具身思维链标注。作者在 LIBERO、LIBERO-Plus、RoboTwin 2.0、SimplerEnv 上分别报告 99.3%、89.9%、93.6%、81.5% 的成功率,并通过消融分析未来预测及辅助监督的作用。模型与实验
怎么看:它把世界模型从昂贵的在线生成器,变成训练阶段的知识来源,适合控制时延敏感的场景。四个数字来自不同仿真基准,不能拼成一个统一的机器人能力分数,也不能直接外推到真实硬件。下一步更值得检查动态表示是否真正改善碰撞、遮挡和接触变化下的决策,以及加入标注和合成数据后的收益中,有多少来自结构、有多少来自数据本身。
5. False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents
中文摘要:自演化搜索 Agent 经常让一个模型出题、另一个解题,再利用双方反馈改进课程。但如果题目伪标签本来就错,解题器学会重复这个错误,内部奖励仍可能上升。论文将这种“共同答错却彼此认可”的现象称为 co-cheating,强调它是训练闭环产生的错误一致性,不需要假设模型有蓄意作弊的意图。
方法与结果:作者先尝试多次带来源和不带来源的验证,但六次额外生成仍只能部分缓解。主要方法 CrossFit 把来源文档分成 A、B 两组:来自 A 的题目由只用 B 训练的辅助解题器评分,反之亦然,从反馈链上切断同源伪标签的反复传播。在 4B、9B 模型中,错误一致占比分别由 6.1%、8.8% 降至 3.0%、3.7%;七项下游搜索评测的平均得分,相对标准耦合自演化提高 8.8、8.4 个点。诊断与 CrossFit 实验
怎么看:这篇最重要的提醒是,系统自己的进步信号也需要外部证据校准。多个角色并不天然意味着独立判断,训练来源和反馈来源重叠时,很容易共同强化同一种偏差。CrossFit 仍没有消灭全部错误,也增加了辅助训练成本。实际复现应同时审计来源划分、重复文档、伪标签正确率和下游成绩,避免把奖励曲线改善直接解释为能力增长。

图源:作者论文 Figure 2。右侧通过来源分组,使反馈解题器不从同组伪标签中学习。
6. The Teacher Is a Direction, Not a Destination: Extrapolating RL-Induced Representation Residuals in On-Policy Distillation
- 点赞:149
- 机构:HF 字段为空;论文首页列出中国科学技术大学、Rutgers University、浙江大学及独立研究者。
- 链接:HF · arXiv · GitHub(10 stars)
- 收录说明:9 月 29 日首发,进入十月月榜。
中文摘要:常规 on-policy distillation 让学生在自己的轨迹上模仿教师输出,教师像一个目标终点。RIDE 则把经过 RL 的教师与其训练前基座进行比较:RL 究竟把内部表示推向了哪个方向?如果沿着这个方向继续学习,学生就不必仅仅逼近教师。论文认为,直接在输出概率上外推会受到语言模型输出头的衰减和采样噪声影响,因此转到隐藏表示空间。
方法与结果:在学生生成的相同前缀上,冻结教师和基座分别前向计算,逐层、逐 token 得到表示残差,再构造越过教师的回归目标。它不是把一条固定向量加到所有输入,而是针对当前轨迹重新估计方向。作者在四组不同规模、架构和预训练来源的基座与 RL 教师配对上,报告学生接近或超过教师,且整体优于输出空间外推。每一组内部仍共享架构、分词器与表示起点。设定、方法及实验
怎么看:这条路线适合研究如何保留并放大 RL 已经获得的变化。它不是任意大模型到任意小模型的通用蒸馏,也不是只靠黑盒 API 就能实现:需要基座、教师和中间层状态。工程上要核算额外前向开销;科学上要检查外推系数、层选择和方向噪声。局部有效的改进方向,继续走远之后未必仍是改进方向。
7. Jeva: System One Models from First Principles
中文摘要:从候选工具、动作或标签中作选择,并不一定要先把全部候选拼成文本,再让语言模型生成答案。Jeva 从决策任务本身提出四个要求:能判断没有合适选项、候选顺序不影响选择、候选数量可变,以及重复候选的计算可以跨请求复用。它试图构建一个原生面向选择和评分的低延迟模型,而不是通用聊天模型的简化提示模板。
方法与结果:共享编码器独立表示请求与各选项,紧凑决策模块只更新请求状态,让其读取不变的选项记忆;对称聚合保障候选重排时的等变性,独立 coverage 估计区分“选项都不适用”和“多个选项难分高下”。项目页报告 4B 版本在 Typed Test 上达到 78.30%,在 600 个选择样本的已测试排列中没有决策翻转;在重复候选测试中,缓存使 p50 延迟从 93.1 ms 降至约 46.7 ms。项目实验
怎么看:它更像工具路由或意图识别系统的一块专用组件,而非通用推理替代品。尤其值得借鉴的是把“无答案”独立建模,以及复用候选表示而不是复用旧决策。不过,低延迟与候选规模、文本长度和缓存命中率有关:项目中 2048 候选的另一项诊断达到 12.04 秒 p50,不能把小候选缓存场景的几十毫秒推广到所有规模。冷启动成本也需要单独计算。
8. MemT-1.0: Towards Memory-Native Evolution
中文摘要:Agent 的长期记忆通常依靠重新塞入历史,或先检索再拼接文本。MemT-1.0 希望把持续记忆变成基础模型计算的一部分:历史信息进入可更新的原生记忆状态,之后回答问题时不必完整访问原始上下文。它同时关注记得住、用得上,以及历史增长后存储和推理开销是否还能控制。
方法与结果:模型基于 Metis 路线,引入 Gated DeltaNet-2 的稳定 token 级更新,并用 Mixture-of-Storage 扩展容量;选定的 Transformer 模块加入原生记忆组件,结合动态局部记忆和可训练的 hyper memory。训练包含骨干准备、继续预训练与后训练,使用 34B tokens。作者发布 Nano、Flash 两个版本;在 128K 历史长度条件下,Nano 相对完整上下文 KV cache 达到约 1.86 倍端到端加速,持久存储约为其 1/66。架构与效率实验
怎么看:它和 CarryOn 代表两种不同的减负方式:前者改变模型内部记忆,后者组织外部任务状态。原生记忆适合高频连续交互,但压缩状态未必保留逐字证据;需要精确引用、删除特定记录或审计来源时,外部存储仍有价值。存储倍数只针对论文给定的历史长度与基线,不代表整个服务占用都缩小 66 倍。还应考察新旧信息冲突、遗忘与长期更新稳定性。
9. Thinking Inertia: LLMs Keep Thinking When Told Not To
中文摘要:给模型关掉 thinking 模式,或要求“只输出答案”,真的能得到没有显式推理的回答吗?论文指出,输出短不等于没有推理,输出长也可能只是重复和填充。它将回答拆成答案前文本与最终答案,把不思考作为一种需要单独评测的输出控制能力,研究模型在不同题型和提示干预下是否仍会持续展示推导。
方法与结果:评估分为三层:Empty-Thinking Rate 看能否严格只给答案;Question–Pre-answer Relevance 看前置文本是否与问题相关;Explicit Inference Rate 再判断是否含有可见推理。作者比较六个模型、六种干预,覆盖布尔题、选择题和开放题,并用人工验证检查指标。结果显示,显式限制无法稳定消除推理文本,答案空间越开放越明显;开放题还会暴露输出服从性和准确率之间的权衡。评测设计与结果
怎么看:这对低延迟调用、结构化输出和产品交互很实用:配置项名称不是行为保证,最终仍需测真实输出。但是,这篇研究观察的是可见文本,不能据此判断模型内部有没有计算、隐藏推理是否被完全关闭。系统评测最好把可见推理、最终格式合规、准确率、延迟和计费分别记录,别用回复长度一个指标替代全部。提供候选项可能改善直接作答,却也改变了原任务的信息条件。
10. Has GPT-6-Astra Achieved Embodied Intelligence?
中文摘要:这份报告不是发布新的 VLA,而是系统考察通用模型在机器人任务中的能力边界。研究覆盖桌面操作、人形机器人、移动平台和灵巧手等十二项基准,并进一步测试八种真实机器人配置。作者区分了“具备完成具身任务的能力”和“足以在现实中经济、可靠地工作”,认为前者的进展明显,后者仍有实质缺口。
方法与结果:实验允许模型从训练集示范构建 ICL 知识包,并把部分任务的执行步数放宽到官方预算的最高十倍。报告同时研究高层推理模型和低层控制器之间的闭环协作,观察额外时间如何支持失败恢复。真实部署则暴露示范获取成本、物理状态核验、不可逆失败及长任务进度保持等问题。作者还提出一种新评测原型:不提供域内示范,模型思考时现实世界的时钟继续前进。协议与部署分析
怎么看:最有价值的是它把测试协议讲明白了。若候选系统用了示范知识包和更长执行预算,而对比基线沿用标准预算,就不能把分数差全部归因于模型本体,更不能称作同预算零样本胜出。这更接近能力上界探测。真正的机器人评测应同时报告完成率、耗时、人工准备成本和失败代价;在物理系统里,多试几次并不总是可行,拖延本身也可能导致任务失败。
11. UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement
中文摘要:图像模型拿到反馈后会改图,并不意味着下一次不看反馈就能画得更好。UniEvo-VL 试图把修正经验保留在模型中:教师看到针对生成结果的批评与修订提示,学生只看到原始提示;在学生自己的去噪轨迹上,匹配两者的局部生成预测,让反馈的价值从一次性的推理技巧变成可持续的生成能力。
方法与结果:具体实现基于 Qwen-Image-2512,更新生成侧 LoRA,基础权重、编码器、VAE 和反馈组件保持冻结。论文主表中,普通 UniEvo-VL 的 GenEval 从 0.747 升至 0.808,但 GenEval2 原生指标为 32.37,略低于表中基线 32.58;35.53 来自外部 GPT5.6-Luna 评审配置。增加修订验证的配置又有不同结果。因此,摘要所列增益不能合并成同一配置在所有任务上全面改善。方法附录与主表 1
怎么看:它与 SRD 都在做“训练时多看信息,部署时少依赖信息”,但传递的是图像纠错条件,而不是行动前瞻。真正要关注的是改进有没有保留到原始提示的直接生成中,以及理解模型能否识别生成器的关键错误。文字渲染结果并不一致,也说明评审能力有任务边界。复现时应拆开评审模型、是否过滤反馈、是否追加推理轮次,不能统称为无外部监督的自我进化。
12. Scaling Agentic Data for Long-Horizon Terminal Intelligence
- 点赞:128
- HF 机构:alibaba;项目页列出中国科学技术大学、高德地图及南方科技大学。
- 链接:HF · arXiv · 项目、数据与模型
- 开源情况:HF 未列出 GitHub;项目页提供环境、轨迹和模型权重入口。
中文摘要:长轨迹的价值不在于命令数量多,而在于保留探索、判断、实现、失败后调整和最终验证之间的依赖。TerminalHorizon 指出,合成任务环境时很容易提前完成最关键的工作,剩下的轨迹虽然看起来像专业任务,实际上只需照着现成路径执行。它用独立执行来发现这些被省掉的工作,再重建环境,使训练样本真正需要持续解决问题。
方法与结果:流程先从专业工作构建任务,再通过独立挑战检查“预期工作”和“实际所需工作”的缺口;之后在同一目标上逐步增加依赖前序结果的新要求。项目提供 1535 个环境、2852 条轨迹,涉及 25 个专业领域和 27 类行为模式。以这些数据微调 Qwen3.5-27B 后,作者报告十二项基准均有提升;Terminal-Bench 2.1 从 46.82% 升至 60.67%,另有每例十二小时预算的持续科研案例。数据与实验
怎么看:它适合和“增加合成数据量”的工作对照阅读,重点在恢复任务本应存在的难度,而不只是扩写指令。对数据团队,独立试跑后的环境重建是一种可操作的质量检查。也要注意更长轨迹可能来自低效试错,不能直接等同于更强智能;还应检查验证器是否泄漏解题路径、教师轨迹是否可靠,以及改进能否迁移到合成模板之外的真实任务。
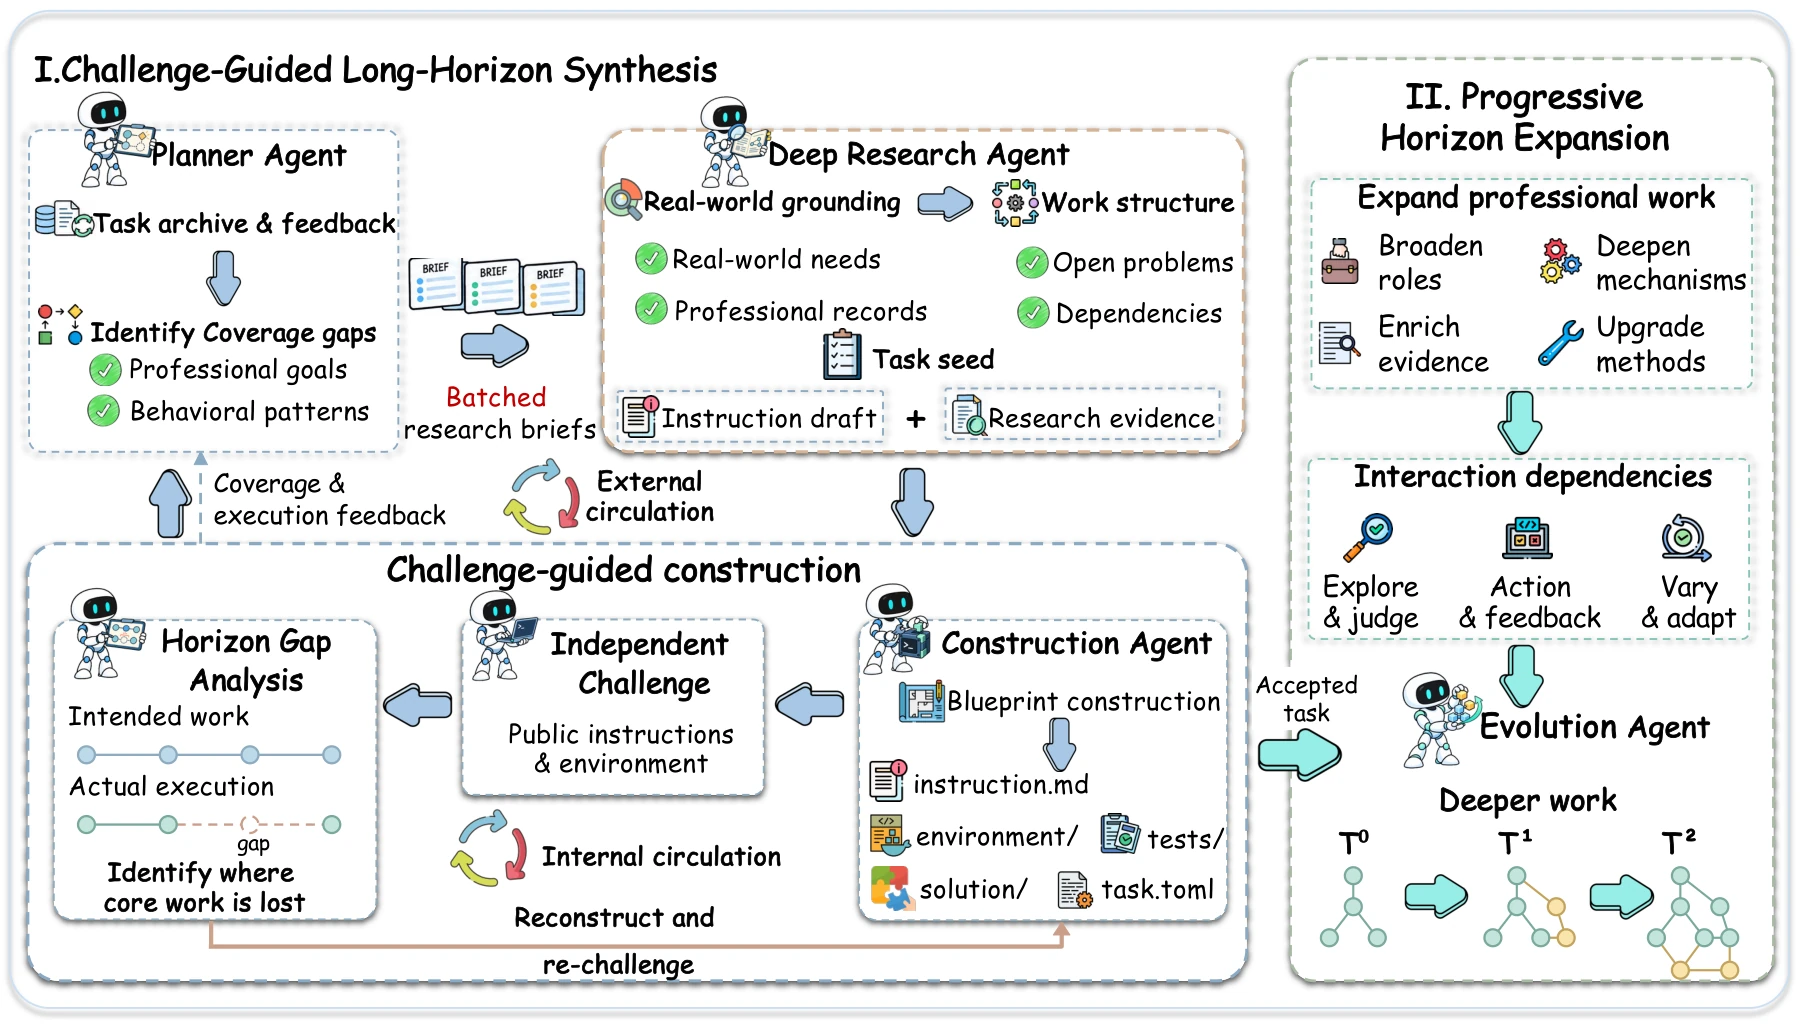
图源:作者项目页 Method。左侧是挑战驱动的环境构造与重建,右侧是持续扩展任务要求。
13. TokenRouter: Efficient Serving System for Token-Level LLM Routing
中文摘要:让大小模型在同一回答中按 token 分工,算法上可能节省算力,但服务系统未必能兑现收益。传统引擎围绕一个模型组织解码,一旦请求频繁切换模型,就会遇到步调不同、批次等待和重复调度。TokenRouter 关注这个基础设施问题:如何让路由逻辑容易实现,同时让不同模型按照各自的节奏持续执行。
方法与结果:开发者从单请求视角描述路由,运行时则为每个模型维护独立子服务,异步分发和恢复请求。KV cache 留在对应模型本地,传递的是新增 token 与路由状态;请求暂时离开后保留服务状态,避免回来时重新完成全部准入流程。Delayed Batching 在不规则到达之间寻找合适的批处理时机,参数由吞吐模型指导。作者跨算法、负载和模型配对报告解码吞吐提高 2.01 至 64.15 倍。系统设计与评测
怎么看:这是执行引擎的改进,不等同于提出了一个所有场景都更准的路由策略。很高的最大倍数也反映了部分旧系统对细粒度切换适配不佳,不能解释成任意业务回答都快 64 倍。落地需要一起测并发吞吐、单用户延迟、GPU 利用率、切换开销和答案质量;异步与延迟凑批可能提高总吞吐,却未必按相同比例改善每个请求的尾延迟。
14. Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
中文摘要:在城市级三维场景中,根据一句描述找到某栋建筑、某辆车或某片区域,传统办法往往先准备大量候选框再排序。场景越大,候选生成和比较越昂贵。Urbex 把它改写成主动搜索:视觉语言 Agent 查看全局场景,查询地标、放大区域、切换观察角度,然后提交目标三维框,而不是先枚举所有可能对象。
方法与结果:系统把三维城市表示成可交互的多视图环境,工具包含 query、zoom、tilt、orbit 和 commit;使用定位奖励与探索塑形奖励训练工具调用策略。在项目页的 CityRefer 测试表中,Urbex 在两个划分上的 Hit@1 为 25.8 和 23.9,所比较的 CityAnchor 为 23.4 和 14.2;单次时间由 32.1 秒降到 3.2 秒。排序基线可用真实实例框,Urbex 不依赖预生成候选,并在 STPLS3D-Refer 上报告零样本迁移结果。方法与对比表
怎么看:它展示了工具接口如何改变空间理解的计算方式:把一次巨大输入,拆成有目的的多轮观察。对地图、城市数字孪生和大场景检索有启发,但不依赖候选框不等于不需要场景准备,仍需要三维数据、渲染和定位接口。速度提升也只是相对特定强基线。面对遮挡、地标缺失或初次搜索走错区域时,是否能够可靠回退,比单条成功演示更重要。
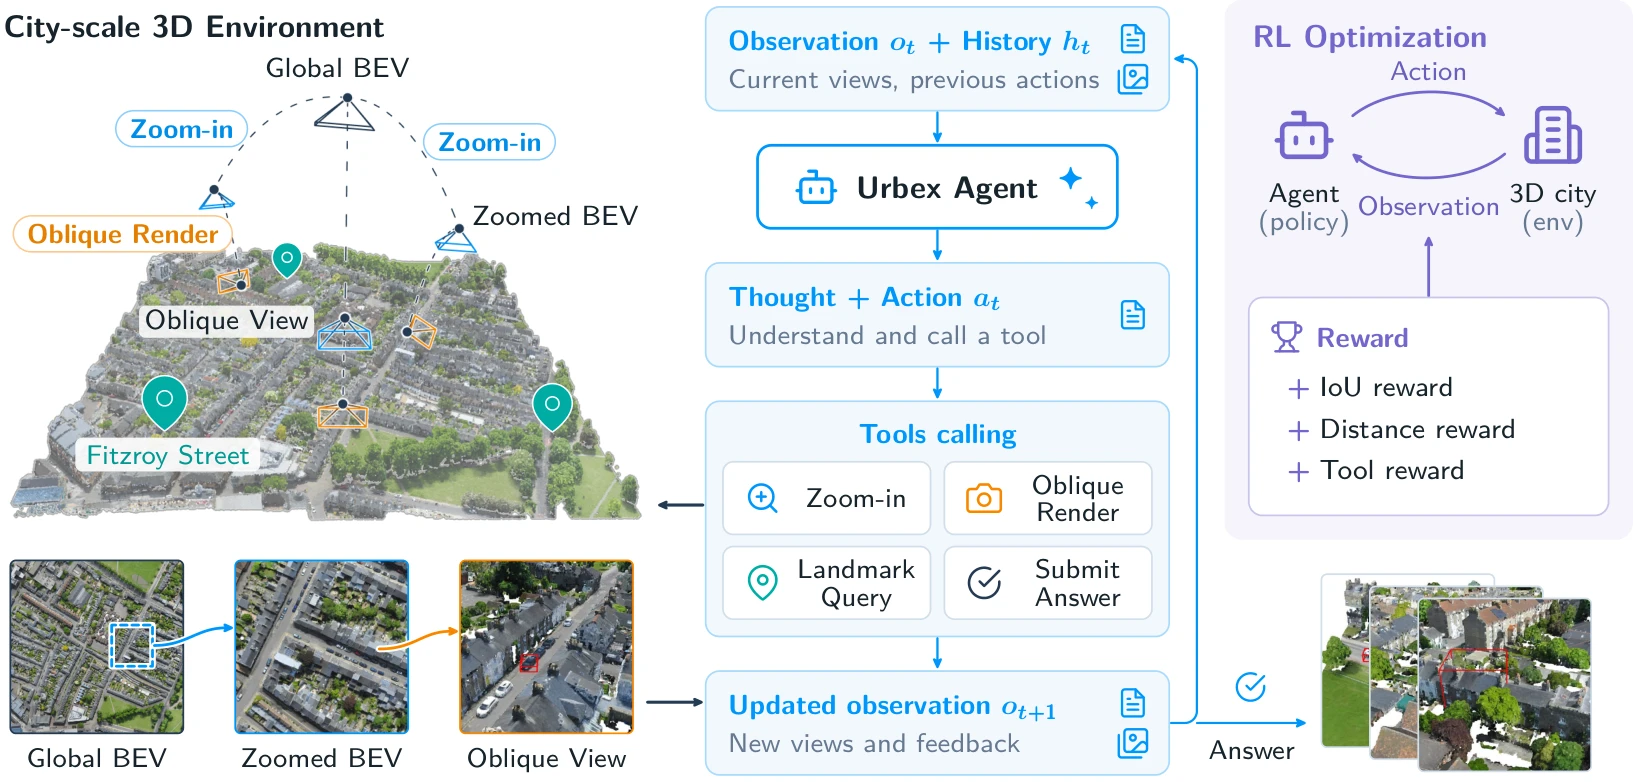
图源:作者项目页 Method Overview。Agent 通过局部观察逐步定位,而非对完整候选列表一次性排序。
15. Pack Light, CarryOn: Building Object-Oriented Context for Long-Horizon Agents
- 点赞:116
- HF 机构:McAuley-Lab;论文作者单位为 University of California San Diego。
- 链接:HF · arXiv · GitHub(5 stars)· 项目页
中文摘要:长任务的进度往往已经保存在文件、网页或工作区中,Agent 却反复读取描述“这些进度如何产生”的聊天历史。CarryOn 提出按可继续使用的任务对象组织上下文:已有文件负责承载完成的工作,执行上下文保留剩余目标和约束,最近的交互留作 live tail。核心不再是把旧对话总结得更短,而是让下一步直接从已确认的任务状态继续。
方法与结果:运行时跟踪 continuation carriers,为对象绑定证据,在必要时检查环境状态;折叠历史后,只修订受影响的记录,保留仍有效的记录,并联合更新执行上下文。使用相同 Claude Opus 4.7 主体时,OSWorld 2.0 的 partial score 从 43.9% 升至 49.7%,BrowseComp-Plus 从 49% 升至 56%;总 token 分别减少 51.9%、22.9%。前一个提升是部分完成评分的 5.8 个百分点,不是完整任务成功率的同幅提升。方法与实验主表
怎么看:它很贴近实际办公与编码 Agent:产物存在不等于产物正确,引用路径也不等于状态仍然有效,因此证据绑定和环境核验不能省。外部对象改变后,旧上下文必须知道哪些结论需要更新。相比不断生成摘要,这种增量维护可能更适合长期任务,但也引入对象身份、版本和失效管理的工程成本。评测时应把维护调用也计入总费用,而不是只计算主 Agent 节省的 token。

图源:作者论文 Figure 2。下方依次跟踪候选对象、准备证据、联合更新并验证提交。
16. Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
中文摘要:扩散式视觉语言模型会反复去噪生成答案,每一步都处理整张图片,虽然图片本身没有变。LOWN 问的是:这一轮解码真的需要重新看图吗?它区别于永久删除部分视觉 token 的剪枝方法,改为根据当前预测动态跳过整次视觉处理,在需要视觉信息时仍保留访问完整图片的能力。
方法与结果:模型保存最近一次带图预测作为 anchor,每步先做较便宜的 TEXT-ONLY 前向,检查预测是否与 anchor 一致;满足条件的一段候选 token 可以直接揭示,不足时才重新执行 FULL 前向、刷新 anchor。这个判定同时控制看图频率和每步生成量,不需要额外训练或调参阈值。十项评测中,LOWN 平均保留 LLaDA-V 基线 99.6% 的得分,解码 FLOPs 为基线的 35.3%,并可叠加剪枝和缓存。算法与评测
怎么看:它把优化单位从“每次少看一点”变成“某些步骤完全不用再看”,适合和视觉剪枝组合。但 certificate 是基于预测一致性的判据,不是答案正确性的严格证明;论文也报告新一轮完整视觉计算仍会推翻少量已认证 token。35.3% 是解码计算量,不是整条请求耗时。部署时还需检查细粒度 OCR、图表和视觉依赖较强问题上的错误分布,避免平均分掩盖局部退化。

图源:作者论文 Figure 3。预测一致时跳过视觉前向,不足以继续解码时重新读取图片。
17. Hy-Nomas: Towards Free-form Interactive World Generation
中文摘要:交互式世界生成不只是把视频接长,还要让后续指令生效,同时保留已经发生的动作及其影响。Hy-Nomas 使用 8B 扩散骨干,支持多轮自由文本指令和连续相机控制,根据当前输入与缓存历史生成可变长度片段。它希望用户在生成过程中继续调整场景与动作,而不是一次提交完整脚本后等待整段视频。
方法与结果:关键设计是让结构化视频描述与动作感知因果注意力配合:场景描述可以跨片段保留,而动作指令只作用于指定时间窗口,减少旧动作持续污染新片段。视觉语言 Prompt Enhancer 将用户请求和多模态历史转换为下一段的结构化条件。训练逐步加入因果生成、文本交互、相机控制和模型自产历史,再进行扩散蒸馏。作者报告人类评测优势,并发布权重、代码与适配流程;仓库提供单张 RTX 4090 的低显存推理路径。论文、部署说明
怎么看:它适合互动叙事和可操控视频原型,但能接收实时输入不等于所有配置都能实时产出画面,能在消费级显卡运行也不等于延迟足够低。更应测试的是多轮累积误差:离开一个区域后再回来,角色、物体和动作后果是否仍一致。视觉上像一个世界,不自动意味着具备可验证的物理状态或游戏逻辑;这两类要求应单独评估。
18. Work Agents: Systems, Capabilities, and Optimization
- 点赞:112
- HF 机构:Shanghai Jiao Tong University;作者团队还包括香港大学、香港科技大学(广州)、清华大学等。
- 链接:HF · arXiv · GitHub 文献清单(74 stars)· 项目页
中文摘要:这是一篇面向工作型 Agent 的综述与框架论文。它把 Agent 定义为基础模型和运行框架共同构成的系统:在具有持续状态的工作区中,使用工具、操作应用、协调流程,最终交付可验证结果。关注点从“能生成什么内容”,转向“能否接受委托并把工作完成”,产物可以是答案、可编辑文档,也可以是工作区中实际发生的有效改变。
框架与内容:论文以 work persistence 和 work openness 两个维度描述工作条件,分别关注工作的持续性,以及环境与任务需求的开放程度;再按范围和组织方式划分五类数字工作,整理五组核心能力,并讨论模型优化、harness 优化及二者的联合优化。配套仓库按系统方法、benchmark 和基础研究组织文献,覆盖办公、企业业务、软件工程、科研与计算机使用。它是综述资源,不是一个已经复现这些能力的通用执行器。论文摘要、作者资源库
怎么看:适合在搭建评测或梳理产品技术路线前阅读。对于实际系统,我会沿着它的结果导向进一步检查:文件是否真的修改、结果能否打开、需求有没有遗漏、状态变化能否追踪,而不只看最后一条回复是否流畅。综述本身不提供统一胜出的新算法,也不能用分类数量证明系统成熟。真正困难的仍是将持续任务中的可靠性、成本与人工接管需求变成可重复测量的指标。
19. Learning from Fleet Experience: A Collective Learning Paradigm for Robots
- 点赞:111
- 机构:HF 字段为空;论文与项目页确认 Tsinghua University、AgiBot、Infinigence AI。
- 链接:HF · arXiv · 项目页 · 项目链接的 RLinf 代码库
- 开源说明:RLinf 是从作者项目页补充的基础设施入口,不在本次 HF 的 GitHub 字段统计中。
中文摘要:机器人部署后会产生大量执行经验,但让人类远程操作员持续盯着每台机器、随时接管失败,并不容易扩展。Collective Experience Learning 让机器人群共享成功与失败经历:失败用来提出“这里还不会”的检索问题,其他机器的成功动作提供训练目标,从而持续改进共用策略,而不必每次失败都新增专家纠正示范。
方法与结果:FERT 根据失败前的视觉与关节状态,检索成功轨迹中相似片段,并提高这些动作片段在微调中的采样权重;FATS 异步协调采集、优化和策略分发,让局部故障不阻塞整个机器群。五项真实操作任务在未参与采集的机器人上、每项 120 次试验中达到 93.3% 至 99.2% 成功率。手机包装任务使用 96 台机器人积累经验后,从 79.2% 提高到 98.3%。但初始化使用人类示范和纠正,后续仍有人提供结果标签并复位环境。项目方法与实验
怎么看:它把集群价值从“更多机器一起采数据”推进到“相互补齐失败场景”,很适合有重复作业和同类硬件的场景。必须保留两个边界:不新增专家纠正动作,不等于完全无人;在未参与采集的同型机器人上有效,不等于跨任意硬件泛化。扩容收益还需结合设备利用率、复位人力和通信成本计算,不能只看机器人数量增加后的最终成功率。
20. Deep Search in Real-World Web Environments
- 点赞:107
- 机构:HF 字段为空;论文首页列出香港科技大学(广州)、复旦大学等高校,以及 SAP、Microsoft Research 等作者单位。
- 链接:HF · arXiv · GitHub(25 stars)
中文摘要:深度搜索在静态文档库中表现好,不意味着能在真实互联网完成调查。现实证据可能藏在视频、音频、异构文件和需要交互的网页中,Agent 必须自己发现来源、获取内容并拼接证据链。OpenDS 将这种开放网络研究定义成可评测任务,要求跨多个独立来源,最终给出一个能够核实的唯一事实答案。
方法与结果:作者构建 OpenDS-World,包含 200 个经过独立人工验证的高难任务,在统一工具和执行协议下比较十二个前沿模型,最佳准确率为 39.0%。另有 50 名参与者完成 1000 次独立解题,正确率为 21.1%;人工允许使用普通浏览器,但不能使用 LLM 工具,每题没有统一时限。论文还分析调用方式、成本、终止决策和失败恢复,显示深搜差距不只来自知识,也来自持续组织工具与证据的能力。基准与人类测试协议
怎么看:它对深度研究产品有很强的现实参考价值:真正的难点经常是证据访问和任务管理,而不是最后一段文字组织。但不能据此笼统宣称 AI 已全面超过人类研究能力,参与者构成、工具限制和任务分布都影响比较。实时网页还会变化,复现实验应保存执行日期、证据页面、工具版本和预算。39% 的最佳结果同时意味着,大量复杂搜索仍需要验证与人工兜底。
小结
这个月最值得保留的判断是:能力提升往往来自更合理的信息与执行组织,而不只是更长的推理。把失败转成前瞻监督、把聊天历史转成任务对象、把重复视觉计算改成按需访问,都是很具体的改进方向。但判断是否真正有效,仍要回到独立证据、同等预算和可验证产物。点赞代表社区关注度,不代替论文质量评审。